• 回去了 旅途平安
    回去了 旅途平安
    1
    0 留言 0 分享次數 257 瀏覽次數 0 評論
  • Google Ad 出價策略重新調整.

    https://youtu.be/Uaz0h1AFPsU?si=-P0CsszUdplweX5z
    Google Ad 出價策略重新調整. https://youtu.be/Uaz0h1AFPsU?si=-P0CsszUdplweX5z
    2
    0 留言 0 分享次數 157 瀏覽次數 0 評論
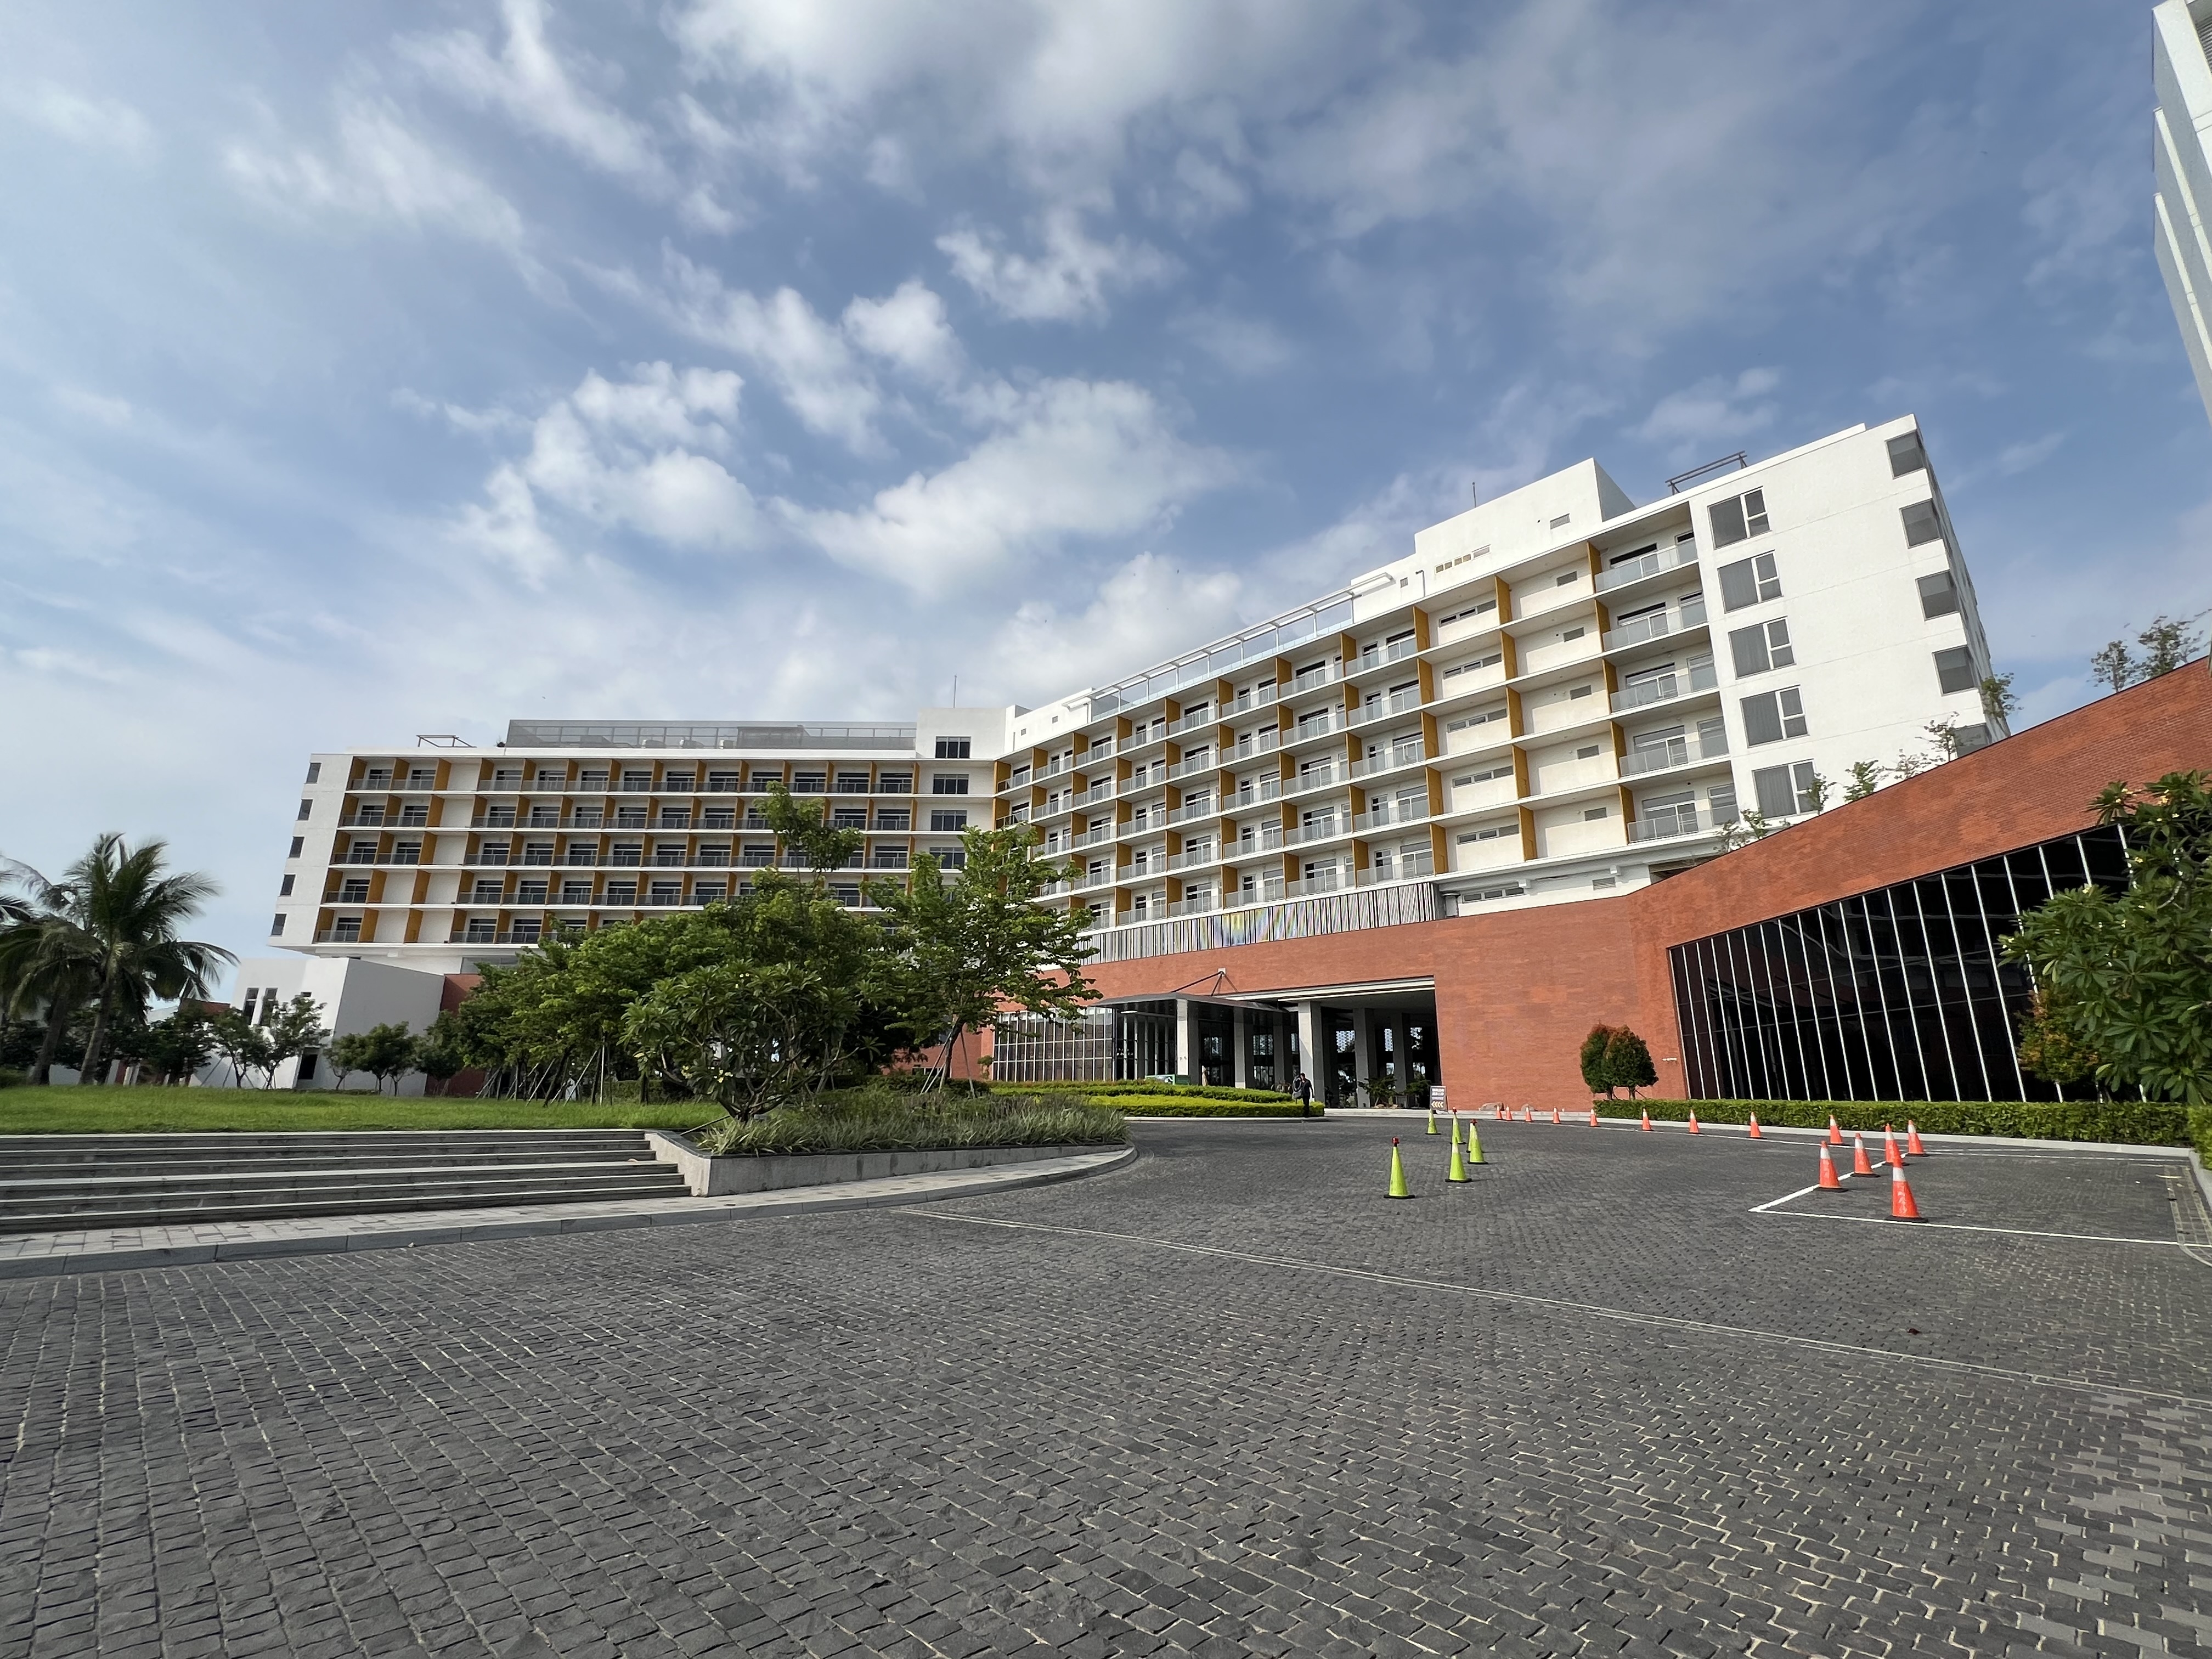
  • 第一次來住台南的國宴餐廳!福爾摩沙酒店.

    五星級酒店!

    總統就職國宴餐廳.
    第一次來住台南的國宴餐廳!福爾摩沙酒店. 五星級酒店! 總統就職國宴餐廳.
    2
    0 留言 0 分享次數 148 瀏覽次數 0 評論
  • Ayurvedic Medicine for Piles | Shri Chyawan Ayurved

    Support your digestive health with ayurvedic medicine for piles from Shri Chyawan Ayurved. Our herbal formulations are based on traditional Ayurvedic principles and carefully selected herbs to promote natural wellness and balanced daily living.

    Visit: https://www.shrichyawanayurved.com/collections/ayurvedic-medicine-for-piles

    #AyurvedicMedicineForPiles #ShriChyawanAyurved #Ayurveda #HerbalCare #NaturalHealing #DigestiveHealth #TraditionalAyurveda #HealthyRoutine #WellnessJourney #HolisticHealth
    Ayurvedic Medicine for Piles | Shri Chyawan Ayurved Support your digestive health with ayurvedic medicine for piles from Shri Chyawan Ayurved. Our herbal formulations are based on traditional Ayurvedic principles and carefully selected herbs to promote natural wellness and balanced daily living. Visit: https://www.shrichyawanayurved.com/collections/ayurvedic-medicine-for-piles #AyurvedicMedicineForPiles #ShriChyawanAyurved #Ayurveda #HerbalCare #NaturalHealing #DigestiveHealth #TraditionalAyurveda #HealthyRoutine #WellnessJourney #HolisticHealth
    0
    0 留言 0 分享次數 990 瀏覽次數 0 評論
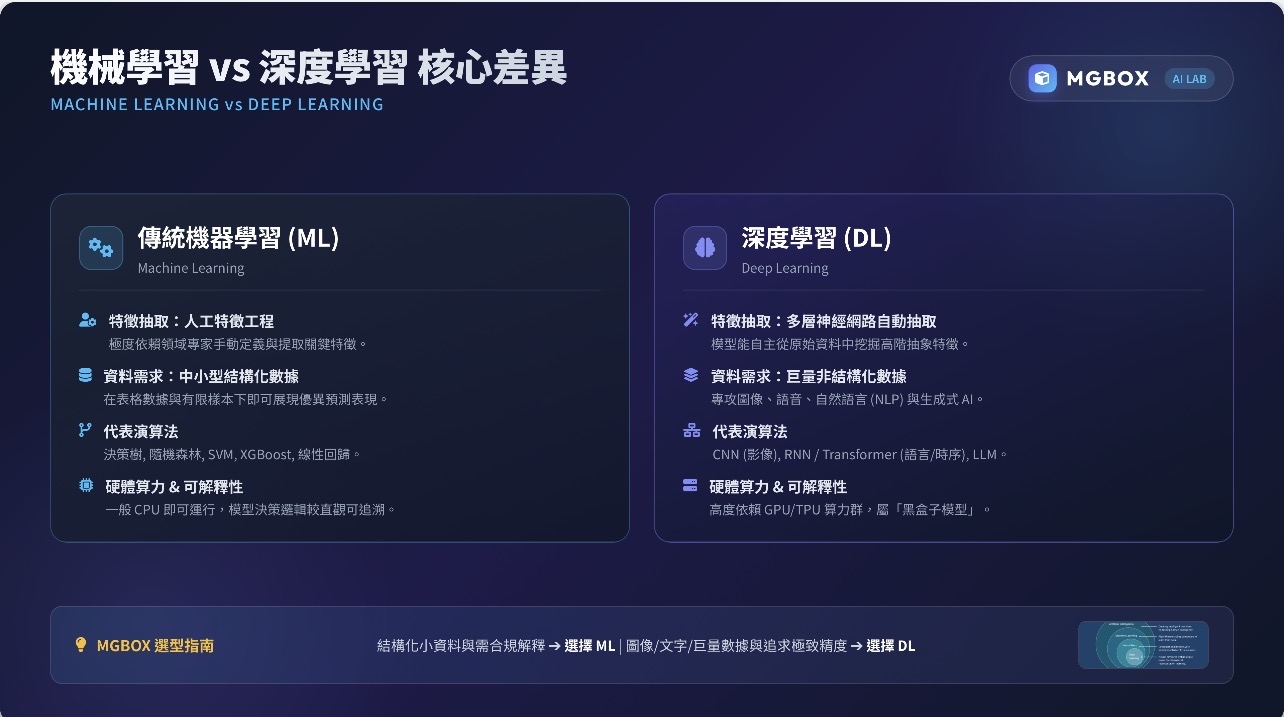
  • 機械學習跟深度學習的差異?

    簡單來說,深度學習是機器學習的一個分支(類似於「矩陣是數學的一部分」的概念)。兩者最大的核心差異在於資料處理方式、模型複雜度與對人工特徵工程(Feature Engineering)的依賴程度。

    2. 用一個直觀例子理解:分辨「貓與狗」
    假設我們要設計一個系統來識別圖片中的動物是貓還是狗:
    傳統機器學習的做法:
    工程師需要先動腦想出貓和狗的差別(特徵),例如「耳朵形狀」、「鬍鬚長度」、「眼睛比例」,並用程式碼手動將這些特徵抽取出來傳給演算法,演算法再根據這些特徵去分類。如果圖片背景太雜亂或特徵沒抓好,準確率就會大幅下降。
    深度學習的做法:
    直接把數十萬張「貓與狗」的原圖丟進深度神經網路(如 CNN)。網路的第一層可能會學習識別邊緣與線條,中間層學習識別幾何圖形與器官,深層則學習組合成完整的面部結構。整個特徵抽取的過程全由模型自動完成。
    3. 如何選擇?
    適合選擇機器學習的情境:
    資料量較少或主要是結構化表格資料(例如:客戶流失率預測、信用評分、房價預測)。
    需要清楚解釋模型為何做出這個決策(符合法規或業務需求)。
    算力資源與預算有限,追求快速上線。
    適合選擇深度學習的情境:
    處理非結構化資料(例如:影像識別、自然語言處理、語音識別、生成式 AI/LLM)。
    資料量極大,且傳統演算法的效能已經達到瓶頸。
    追求極致的預測準確度,且不在意決策過程是否為黑盒子。
    機械學習跟深度學習的差異? 簡單來說,深度學習是機器學習的一個分支(類似於「矩陣是數學的一部分」的概念)。兩者最大的核心差異在於資料處理方式、模型複雜度與對人工特徵工程(Feature Engineering)的依賴程度。 2. 用一個直觀例子理解:分辨「貓與狗」 假設我們要設計一個系統來識別圖片中的動物是貓還是狗: 傳統機器學習的做法: 工程師需要先動腦想出貓和狗的差別(特徵),例如「耳朵形狀」、「鬍鬚長度」、「眼睛比例」,並用程式碼手動將這些特徵抽取出來傳給演算法,演算法再根據這些特徵去分類。如果圖片背景太雜亂或特徵沒抓好,準確率就會大幅下降。 深度學習的做法: 直接把數十萬張「貓與狗」的原圖丟進深度神經網路(如 CNN)。網路的第一層可能會學習識別邊緣與線條,中間層學習識別幾何圖形與器官,深層則學習組合成完整的面部結構。整個特徵抽取的過程全由模型自動完成。 3. 如何選擇? 適合選擇機器學習的情境: 資料量較少或主要是結構化表格資料(例如:客戶流失率預測、信用評分、房價預測)。 需要清楚解釋模型為何做出這個決策(符合法規或業務需求)。 算力資源與預算有限,追求快速上線。 適合選擇深度學習的情境: 處理非結構化資料(例如:影像識別、自然語言處理、語音識別、生成式 AI/LLM)。 資料量極大,且傳統演算法的效能已經達到瓶頸。 追求極致的預測準確度,且不在意決策過程是否為黑盒子。
    4
    1 留言 0 分享次數 346 瀏覽次數 0 評論
MGBOX https://magicbox.mg