貼文

查看每個人的動態和想法

貼文

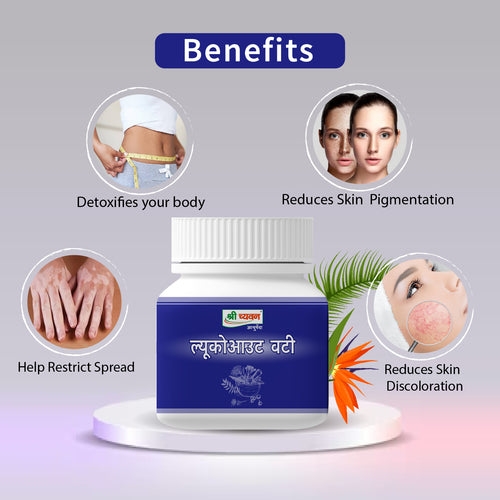
  • Best Ayurvedic Medicine for Leucoderma | Shri Chyawan Ayurved

    Leuko-Out Vati by Shri Chyawan Ayurved offers herbal support for healthy skin using traditional Ayurvedic ingredients. It is a trusted choice for people searching for the best ayurvedic medicine for leucoderma and natural skin wellness.

    Visit: https://www.shrichyawanayurved.com/products/leuko-out-vati

    #BestAyurvedicMedicineForLeucoderma #ShriChyawanAyurved #Ayurveda #HerbalMedicine #NaturalHealing #SkinCare #HealthySkin #HolisticCare #TraditionalAyurveda #HerbalProducts #NaturalSupport #WellnessJourney #SkinWellness #AyurvedicLifestyle #DailyCare
    1K 瀏覽次數

  • 一、建立觀察的多層框架

    單一方法看不到全貌,通常需要交叉:

    • 行為層:實際使用軌跡、購買序列、App/網站點擊流、退換貨紀錄
    • 語言層:評論、客服對話、社群貼文、訪談逐字稿
    • 情緒/生理層:表情辨識、語氣分析、眼動、生理訊號(若能取得)
    • 情境層:使用場景、時間、社交壓力、決策當下的干擾因素

    關鍵是同時蒐集「說了什麼」與「做了什麼」,兩者落差往往是最有價值的洞察來源。

    二、心理行為的編碼架構

    把原始觀察轉成可比較的結構,常見維度:

    1. 需求動機(功能性 / 情感性 / 社會性,可對應 Maslow 或 JTBD 框架)
    2. 決策階段(察覺→比較→猶豫→購買→使用→分享)
    3. 認知偏誤(錨定、從眾、損失規避等,標註出現情境)
    4. 情緒曲線(沿著使用旅程標記情緒高低點,找出”痛點”與”驚喜點”)

    三、AI 如何建構知識結構

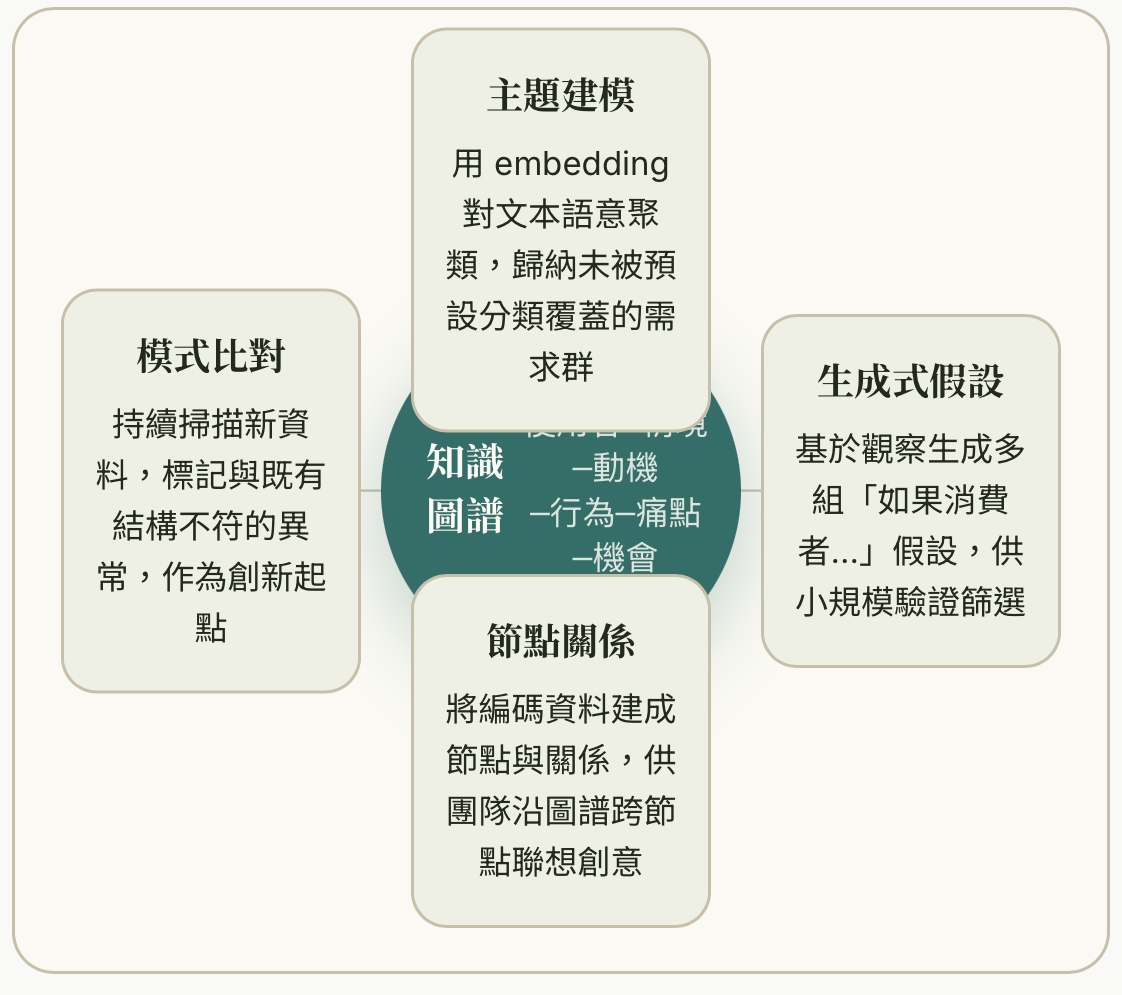
    • 主題建模/聚類:用 LLM 或 embedding 對大量文本做語意聚類,自動歸納出未被預設分類覆蓋的潛在需求群
    • 知識圖譜:把「使用者—情境—動機—行為—痛點—機會點」建成節點與關係,讓創意人員能沿著圖譜跨節點聯想(例如同一動機在不同情境下的變體)
    • 生成式假設:讓 AI 基於觀察資料生成多組「如果…消費者可能…」的假設,再用小規模驗證篩選
    • 模式比對:AI 持續掃描新資料,標記出與既有知識結構不符的異常案例,這些異常常是創新的起點

    四、落地流程建議

    原始觀察 → 人工/AI編碼 → 建立知識圖譜 →
    AI歸納潛在模式 → 團隊共創坊產出概念 →
    小規模驗證 → 迭代更新知識結構

    一份視覺化圖表,把整套框架拆成四個區塊:觀察四層(像地層一樣由外顯到內隱)、心理編碼架構、AI 知識圖譜的中樞結構,、以及落地流程。可以直接用在簡報或內部分享上,也歡迎告訴我要不要針對某個產業(例如零售、SaaS、餐飲)調整範例內容。
    Like
    3
    506 瀏覽次數
  • TAIDE 模型

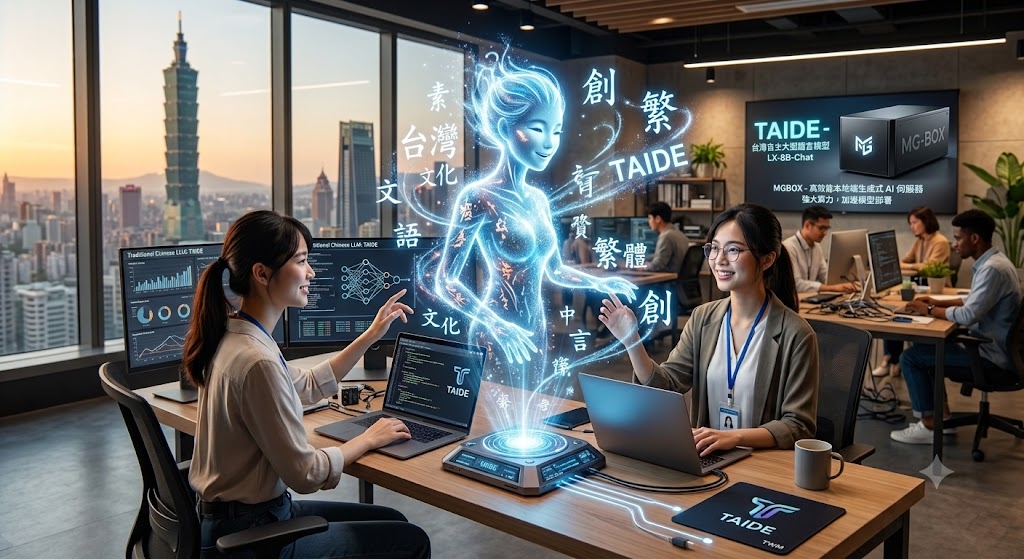
    簡單直接的答案是:TAIDE 模型(如 taide-lx-8b-chat)本身是一個「靜態」的離線權重模型,它無法像線上軟體一樣自動、即時地與網路同步更新最新資訊。它的知識完全停留在當初國科會團隊幫它做封閉式訓練的那個時間點(Data Cutoff)。

    不過,如果你希望讓它擁有「獲取線上最新同步資訊」的能力,在技術架構上是可以透過外掛機制來實現的。以下為您拆解它的運作本質與串接方法:為什麼模型本身無法同步更新?

    包含 TAIDE 在內的所有大語言模型(LLMs),本質上都是一堆「參數矩陣」。它是固定的檔案: 當你從 Hugging Face 下載 Llama-3.1-TAIDE-LX-8B-Chat 到本機或伺服器部署後,它就是一個幾 GB 的固定檔案。

    更新成本極高: 要讓模型吞下新知識,必須重新經過微調(Fine-tuning)或持續預訓練(Continuous Pre-training),這需要耗費大量的 GPU 算力和時間,不可能做到「每分每秒即時同步」。如何讓 TAIDE 變相實現「線上同步更新」?

    如果您在開發應用系統(如 AI 社群平台、智慧客服、企業知識庫)時,需要 TAIDE 回答即時新聞、天氣、或最新的產業動態,業界標準的做法是採用 RAG(檢索增強生成) 或是 Function Calling(函式呼叫) 架構。


    1. 聯網搜尋架構(RAG + Web Search)這是最常見讓 AI 聯網的方法:[使用者輸入問題] ──> [系統後台自動呼叫搜尋引擎 API (如 Google/Bing)]
    │
    ▼
    [TAIDE 根據搜尋結果產出回答] <── [將搜到的「最新網頁內容」作為背景知識餵給 TAIDE]


    優點: 不需要重新訓練模型,TAIDE 就能根據當下搜尋到的網路即時資訊進行精準摘要與回答。


    2. 即時資料庫串接(API / 知識庫同步)如果您的最新資訊是來自特定的內部系統、新聞資料庫或第三方 API(例如當日的台股行情、即時車市交付數據):可以寫一段程式,在使用者提問時,系統先去該資料庫抓取最新數據。 再將這段數據以 Prompt(提示詞)的輸入方式包給 TAIDE,讓它做在地化的語意處理與回應。

    💡 總結建議如果您單純部署 taide-lx-8b-chat,它只會講出它訓練範圍內的臺灣文化與歷史背景。想要它具備「線上同步」的靈魂,就必須在系統外層幫它架設一條能夠連接外網搜尋或即時資料庫的管線。

    #TAIDE 模型
    Like
    4
    488 瀏覽次數
  • Sugar and Sugar Substitute Market Sweetens with Health-Conscious Choices
    The global Sugar and Sugar Substitute Market is experiencing steady transformation as consumers increasingly seek healthier sweetening options for their dietary needs. As per Market Research Future, the market was valued at USD 84.3 Billion in 2025 and is projected to grow to USD 95 Billion by 2035, at a CAGR of 1.2%. The rising health consciousness and shift towards low-calorie...
    312 瀏覽次數
全台活動 · 全台生活更新